
Welcher Statistik-Test passt zu deiner Arbeit?
Zuletzt aktualisiert im · Lesezeit etwa 8 Minuten
Die Daten sind erhoben, SPSS ist offen, und im Menü stehen zwanzig Verfahren, von denen du fünf dem Namen nach kennst. Also probierst du eins aus. Kommt ein Sternchen, war es wohl richtig.
Genau da entstehen die Fehler, die später auffallen. Welcher Test passt, entscheidet sich nicht im Programm, sondern vorher – an drei Fragen, die du in zwei Minuten beantworten kannst, wenn du weißt, worauf du schaust.
Die drei Fragen vor dem ersten Klick
1. Welches Skalenniveau haben deine Variablen?
Das ist die Frage, an der fast alles hängt. Drei Stufen musst du auseinanderhalten:
Nominal heißt: Kategorien ohne Reihenfolge. Studiengang, Geschlecht, ja/nein, qualitativ/quantitativ. Du kannst zählen, wie oft etwas vorkommt, mehr nicht. Ein Mittelwert aus Studiengängen ergibt keinen Sinn.
Ordinal heißt: Es gibt eine Reihenfolge, aber die Abstände sind nicht gleich groß. Schulnoten, Rangplätze, „stimme gar nicht zu" bis „stimme voll zu". Der Abstand zwischen 1 und 2 ist nicht zwingend derselbe wie zwischen 4 und 5.
Metrisch heißt: Zahlen mit gleichen Abständen. Alter in Jahren, Punktwerte, Sekunden, Euro. Hier darfst du rechnen.
Der Streitfall in fast jeder Arbeit sind Likert-Skalen. Eine einzelne Frage mit fünf Stufen ist streng genommen ordinal. Ein Summenscore aus mehreren Items einer validierten Skala wird in der Praxis fast überall wie metrisch behandelt, und das ist auch die gängige Konvention. Wichtig ist nicht, welche Seite du wählst, sondern dass du sie im Methodenteil in zwei Sätzen begründest. Wer das begründet, hat die Frage in der Verteidigung schon beantwortet.
2. Wie viele Gruppen, und sind sie unabhängig?
Zwei Gruppen führen zum t-Test, drei oder mehr zur Varianzanalyse. Entscheidend ist zusätzlich, ob es verschiedene Personen sind oder dieselben.
Verschiedene Personen in verschiedenen Gruppen: unabhängige Stichproben. Dieselben Personen zu zwei Zeitpunkten oder unter zwei Bedingungen: abhängige Stichproben, oft auch „gepaart" oder „verbunden" genannt. Das ist keine Feinheit. Der abhängige t-Test rechnet mit den Differenzen innerhalb jeder Person und hat dadurch mehr Power. Nimmst du hier das falsche Verfahren, verschenkst du entweder Aussagekraft oder du behauptest eine Unabhängigkeit, die es nicht gibt.
3. Unterschied oder Zusammenhang?
Willst du zeigen, dass sich Gruppen unterscheiden, brauchst du t-Test, Varianzanalyse oder ihre nichtparametrischen Verwandten. Willst du zeigen, dass zwei Merkmale zusammenhängen, brauchst du Korrelation, Regression oder Chi-Quadrat.
Die einfachste Probe: Steht in deiner Hypothese das Wort „unterscheiden" oder das Wort „hängt zusammen"? Wenn beides drinsteht, hast du zwei Hypothesen und brauchst zwei Auswertungen.
Der Entscheidungsbaum
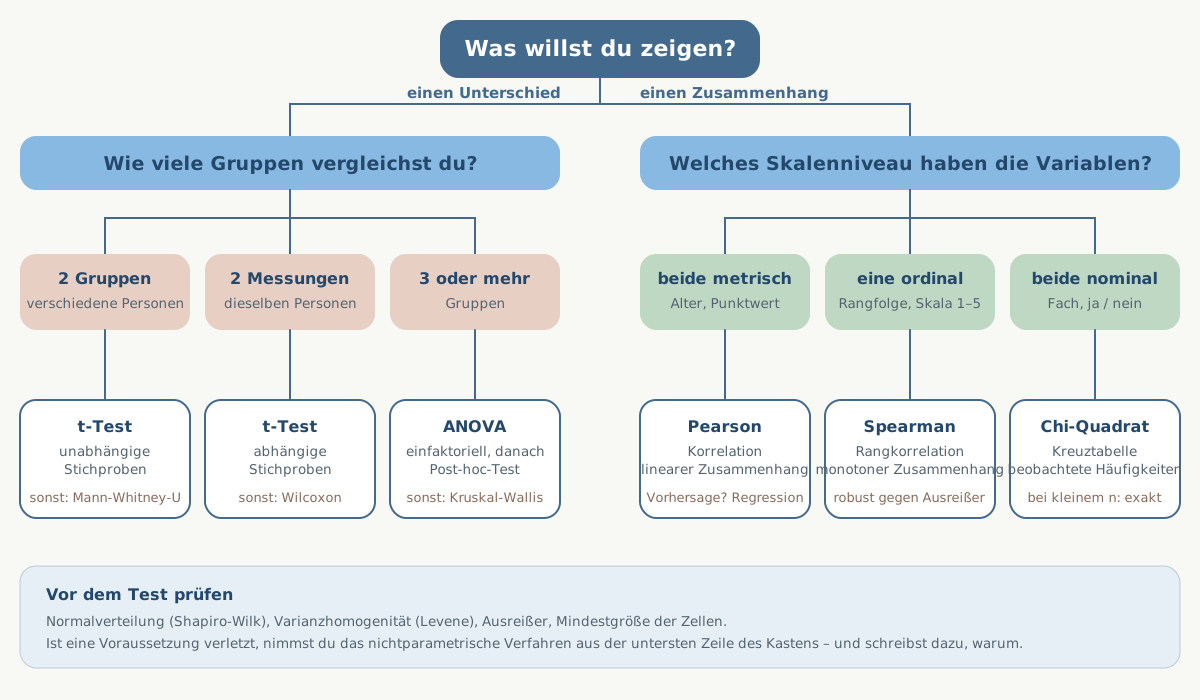
Kurzübersicht: Fragestellung, Test, SPSS-Pfad
| Deine Frage | Verfahren | In SPSS unter |
|---|---|---|
| Unterscheiden sich zwei Gruppen (verschiedene Personen)? | t-Test für unabhängige Stichproben | Analysieren → Mittelwerte vergleichen → t-Test bei unabhängigen Stichproben |
| Unterscheiden sich zwei Messzeitpunkte (dieselben Personen)? | t-Test für abhängige Stichproben | Analysieren → Mittelwerte vergleichen → t-Test bei verbundenen Stichproben |
| Unterscheiden sich drei oder mehr Gruppen? | Einfaktorielle Varianzanalyse, danach Post-hoc | Analysieren → Mittelwerte vergleichen → Einfaktorielle ANOVA |
| Hängen zwei metrische Variablen zusammen? | Korrelation nach Pearson | Analysieren → Korrelation → Bivariat |
| Hängen zwei Variablen zusammen, eine davon ordinal? | Rangkorrelation nach Spearman | Analysieren → Korrelation → Bivariat, Haken bei Spearman |
| Lässt sich eine metrische Variable durch andere vorhersagen? | Lineare Regression | Analysieren → Regression → Linear |
| Hängen zwei kategoriale Merkmale zusammen? | Chi-Quadrat-Test | Analysieren → Deskriptive Statistiken → Kreuztabellen → Statistiken |
Drei Beispiele, durchgerechnet
Alle drei sind erfunden, aber realistisch gerechnet. Ich zeige dir, was du eingibst, was rauskommt und wie der Satz im Ergebnisteil dann aussieht.
Beispiel 1 · Zwei Gruppen vergleichen
Fragestellung: Unterscheidet sich die Prüfungsangst zwischen Studierenden, die in einer Lerngruppe arbeiten, und Studierenden, die allein lernen?
Variablen: Prüfungsangst als Summenscore von 0 bis 40 (metrisch, abhängige Variable), Lernform mit zwei Ausprägungen (nominal, unabhängige Variable). Verschiedene Personen in beiden Gruppen.
Daten: Lerngruppe n = 32, M = 24,6, SD = 6,1. Allein n = 28, M = 28,9, SD = 5,4.
Voraussetzungen: Der Levene-Test wird nicht signifikant (F = 0,84; p = ,363), die Varianzen dürfen als homogen gelten. Also liest du in der SPSS-Ausgabe die obere Zeile ab.
Rechnung: Aus beiden Standardabweichungen ergibt sich eine gepoolte Streuung von 5,78. Der Standardfehler der Differenz beträgt 1,50. Die Mittelwertdifferenz von −4,3 geteilt durch 1,50 ergibt den t-Wert.
So schreibst du es: „Studierende, die allein lernten (M = 28,9; SD = 5,4), berichteten eine signifikant höhere Prüfungsangst als Studierende in einer Lerngruppe (M = 24,6; SD = 6,1), t(58) = −2,87; p = ,006. Die Effektstärke liegt mit d = 0,74 im mittleren bis großen Bereich."
Was Prüfende gern fragen: Warum du die Effektstärke berichtest. Antwort: weil p allein nur sagt, ob ein Unterschied wahrscheinlich nicht zufällig ist, aber nichts darüber, wie groß er ist. Bei großen Stichproben wird fast alles signifikant.
Beispiel 2 · Drei Gruppen vergleichen
Fragestellung: Unterscheidet sich die Schreibproduktivität zwischen drei Betreuungsformen – keine Betreuung, Gruppentreffen, Einzelbetreuung?
Variablen: Geschriebene Wörter pro Sitzung (metrisch), Betreuungsform mit drei Ausprägungen (nominal). Je 20 Personen pro Gruppe.
Daten: Keine Betreuung M = 310, SD = 95. Gruppentreffen M = 395, SD = 88. Einzelbetreuung M = 470, SD = 102.
Rechnung: Die Varianz zwischen den Gruppen ist deutlich größer als die innerhalb. Aus dem Verhältnis der mittleren Quadratsummen (128.166 zu 9.058) ergibt sich der F-Wert.
Und jetzt der Teil, den die meisten vergessen: Die Varianzanalyse sagt dir nur, dass sich mindestens zwei Gruppen unterscheiden – nicht welche. Dafür brauchst du einen Post-hoc-Test. Bei Tukey liegt die kritische Differenz hier bei 72,4. Alle drei Paarvergleiche liegen darüber (85, 75 und 160 Wörter), also unterscheiden sich alle drei Gruppen voneinander.
So schreibst du es: „Die einfaktorielle Varianzanalyse ergab einen signifikanten Effekt der Betreuungsform auf die Schreibproduktivität, F(2; 57) = 14,15; p < ,001; η² = ,33. Post-hoc-Vergleiche nach Tukey zeigten, dass sich alle drei Gruppen signifikant voneinander unterschieden; die Einzelbetreuung erzielte die höchste Produktivität."
Beispiel 3 · Zwei kategoriale Merkmale
Fragestellung: Hängt die Wahl der Forschungsmethode mit dem Fachbereich zusammen?
Variablen: Fachbereich (Psychologie / BWL) und Methode (qualitativ / quantitativ). Beide nominal. Das ergibt eine Vierfeldertafel.
Daten: Psychologie: 38 qualitativ, 42 quantitativ. BWL: 18 qualitativ, 62 quantitativ. Gesamt N = 160.
Rechnung: Bei Unabhängigkeit wären in jedem Fach 28 qualitative und 52 quantitative Arbeiten zu erwarten. Die Abweichung beträgt in jeder Zelle 10 Fälle. Aus den quadrierten Abweichungen ergibt sich χ² = 10,99. SPSS zeigt bei einer Vierfeldertafel zusätzlich die Korrektur nach Yates; die fällt hier auf 9,92, bleibt aber deutlich signifikant.
Achtung bei der Voraussetzung: Der Chi-Quadrat-Test setzt voraus, dass in keiner Zelle eine erwartete Häufigkeit unter 5 liegt. SPSS schreibt das unter die Tabelle. Ist die Bedingung verletzt, nimmst du den exakten Test nach Fisher.
So schreibst du es: „Zwischen Fachbereich und gewählter Forschungsmethode bestand ein signifikanter Zusammenhang, χ²(1; N = 160) = 10,99; p < ,001. Der Zusammenhang war mit Cramérs V = ,26 schwach bis mittel ausgeprägt: In der Psychologie wurde häufiger qualitativ gearbeitet als in der BWL."
Wenn die Voraussetzungen nicht erfüllt sind
Fast jedes parametrische Verfahren setzt etwas voraus. Wenn eine Voraussetzung verletzt ist, ist das kein Grund zur Panik und schon gar keiner, es zu verschweigen. Es ist ein Grund, das Verfahren zu wechseln und den Wechsel zu begründen.
Für die Normalverteilung nimmst du bei kleinen bis mittleren Stichproben den Shapiro-Wilk-Test. Ein Hinweis, der viel Verwirrung erspart: Nicht die Rohdaten müssen normalverteilt sein, sondern die Residuen beziehungsweise die Werte innerhalb jeder Gruppe. Und ab etwa 30 Personen pro Gruppe ist der t-Test gegen Abweichungen ziemlich robust – schau dir zusätzlich immer das Histogramm an, statt dich nur auf den p-Wert des Tests zu verlassen.
Für die Varianzhomogenität nimmst du den Levene-Test. Wird er signifikant, liest du in SPSS beim t-Test einfach die untere Zeile ab, die Welch-Korrektur. Die Freiheitsgrade sind dann keine ganze Zahl mehr, das ist richtig so.
| Parametrisch | Nichtparametrische Alternative |
|---|---|
| t-Test für unabhängige Stichproben | Mann-Whitney-U-Test |
| t-Test für abhängige Stichproben | Wilcoxon-Vorzeichen-Rang-Test |
| Einfaktorielle Varianzanalyse | Kruskal-Wallis-Test |
| Pearson-Korrelation | Spearman-Rangkorrelation |
| Chi-Quadrat bei kleinen Zellen | Exakter Test nach Fisher |
Wie du das Ergebnis berichtest
Ein vollständiger Satz enthält vier Bestandteile: die Kennwerte der Gruppen, die Teststatistik mit Freiheitsgraden, den p-Wert und die Effektstärke. Fehlt die Effektstärke, kommt die Frage danach in der Verteidigung.
Zwei Konventionen, an denen man sofort sieht, ob jemand sauber gearbeitet hat: p-Werte werden ohne führende Null geschrieben – also p = ,03 und nicht p = 0,03, weil p nie größer als 1 werden kann. Und sehr kleine Werte schreibst du als p < ,001 statt p = ,000, was SPSS anzeigt. Null ist ein p-Wert nie.
Die drei häufigsten Fehler
Rückwärts vorgehen. Erst rechnen, dann eine Hypothese suchen, zu der das Ergebnis passt. Das fällt auf, spätestens wenn jemand fragt, warum genau diese Variablen. Die Hypothese steht vor der Auswertung fest.
Alles mit allem korrelieren. Wer zwanzig Zusammenhänge prüft, findet rein zufällig etwa einen mit p < ,05. Wenn du viele Tests rechnest, gehört eine Korrektur des Signifikanzniveaus dazu – oder wenigstens der ehrliche Hinweis, dass die Analyse explorativ war.
Signifikanz mit Bedeutsamkeit verwechseln. Ein signifikantes Ergebnis heißt: Der Unterschied ist wahrscheinlich nicht zufällig entstanden. Es heißt nicht: Der Unterschied ist groß oder praktisch relevant. Genau dafür steht die Effektstärke daneben.
Und falls dein Ergebnis am Ende nicht signifikant wird – das ist kein Scheitern und kostet dich nichts. Wie du ein Nullergebnis wissenschaftlich korrekt diskutierst, steht in einem eigenen Artikel.
Kein Plan, welcher Test zu deinen Daten passt? In einem Einzeltermin gehen wir dein Variablendesign durch, wählen das Verfahren gemeinsam aus und schauen uns deine SPSS-Ausgabe zusammen an.